爬取oss库
前言
2025年底因公司需要,编写了一个健壮的爬取oss库的python脚本,后续有空再完善思路和讲解,具体出处可以参考代码: https://github.com/anTtutu/anttu.code.learn.python/tree/master/oss_download
……一位Java开发者,喜欢研究技术,同时也在学习Golang和Python中,对服务器、Linux使用比较熟悉。欢迎添加技术交流QQ群:655158296
2025年底因公司需要,编写了一个健壮的爬取oss库的python脚本,后续有空再完善思路和讲解,具体出处可以参考代码: https://github.com/anTtutu/anttu.code.learn.python/tree/master/oss_download
……python多版本管理工具整理介绍
| 序号 | 工具名称 | 安装方式 | 说明 | 备注 |
|---|---|---|---|---|
| 1 | pyenv | curl -L https://github.com/pyenv/pyenv-installer/raw/master/bin/pyenv-installer | bash | 比较早出现的 python 多版本管理工具,目前不太活跃了 | |
| 2 | virtualenv | pip install virtualenv | 通过创建虚拟机方式管理 | |
| 3 | anaconda | https://repo.anaconda.com/archive/ | 带了很多科学计算包的发行版,包含conda | |
| 4 | miniconda | https://repo.anaconda.com/miniconda/ | 不带科学计算包的mini版本,只有python和conda | |
| 5 | miniforge | https://github.com/conda-forge/miniforge | miniforge是由社区赞助、领导的,并且用GitHub托管所有的包,使用 (而且只用)conda-forge 作为(默认)下载channel,避开了Anaconda的repository | - |
|
|
|
|
|
|
|
|
|
|
虚拟环境不会在当前环境下创建虚拟环境目录,所有的虚拟环境目录默认放在:/root/anaconda3/envs/
……本地开发python后,需要生成requirements.txt,但是不做处理的话,会把你本地安装的所有module都依赖进来,找到一个根据项目生成依赖的工具
|
|
进入项目根目录
|
|
说明
| 参数 | 说明 |
|---|---|
| –force | 会覆盖前一个requirements.txt |
| –encoding=utf8 | 解决编码问题 |
|
|
官方地址: https://faker.readthedocs.io/
ruby 和 java 下都有类似的 faker 工具,但是对比过 java 的,还是 python 这个完善很多。ruby 的暂没测试
|
|
| 参数 | 说明 |
|---|---|
| city_suffix() | 市,县 |
| country() | 国家 |
| country_code() | 国家编码 |
| district() | 区 |
| geo_coordinate() | 地理坐标 |
| latitude() | 地理坐标(纬度) |
| longitude() | 地理坐标(经度) |
| lexify() | 替换所有问号(“?”)带有随机字母的事件。 |
| numerify() | 三位随机数字 |
| postcode() | 邮编 |
| province() | 省份 |
| street_address() | 街道地址 |
| street_name() | 街道名 |
| street_suffix() | 街、路 |
| random_digit() | 0~9随机数 |
| random_digit_not_null() | 1~9的随机数 |
| random_element() | 随机字母 |
| random_int() | 随机数字,默认0~9999,可以通过设置min,max来设置 |
| random_letter() | 随机字母 |
| random_number() | 随机数字,参数digits设置生成的数字位数 |
| color_name() | 随机颜色名 |
| hex_color() | 随机HEX颜色 |
| rgb_color() | 随机RGB颜色 |
| safe_color_name() | 随机安全色名 |
| safe_hex_color() | 随机安全HEX颜色 |
| bs() | 随机公司服务名 |
| company() | 随机公司名(长) |
| company_prefix() | 随机公司名(短) |
| company_suffix() | 公司性质 |
| credit_card_expire() | 随机信用卡到期日 |
| credit_card_full() | 生成完整信用卡信息 |
| credit_card_number() | 信用卡号 |
| credit_card_provider() | 信用卡类型 |
| credit_card_security_code() | 信用卡安全码 |
| currency_code() | 货币编码 |
| am_pm() | AM/PM |
| century() | 随机世纪 |
| date() | 随机日期 |
| date_between() | 随机生成指定范围内日期,参数 |
| date_between_dates() | 随机生成指定范围内日期,用法同上 |
| date_object() | 随机生产从1970-1-1到指定日期的随机日期。 |
| date_this_month() | |
| date_this_year() | |
| date_time() | 随机生成指定时间(1970年1月1日至今) |
| date_time_ad() | 生成公元1年到现在的随机时间 |
| date_time_between() | 用法同dates |
| future_date() | 未来日期 |
| future_datetime() | 未来时间 |
| month() | 随机月份 |
| month_name() | 随机月份(英文) |
| past_date() | 随机生成已经过去的日期 |
| past_datetime() | 随机生成已经过去的时间 |
| time() | 随机24小时时间 |
| timedelta() | 随机获取时间差 |
| time_object() | 随机24小时时间,time对象 |
| time_series() | 随机TimeSeries对象 |
| timezone() | 随机时区 |
| unix_time() | 随机Unix时间 |
| year() | 随机年份 |
| file_extension() | 随机文件扩展名 |
| file_name() | 随机文件名(包含扩展名,不包含路径) |
| file_path() | 随机文件路径(包含文件名,扩展名) |
| mime_type() | 随机mime Type |
| ascii_company_email() | 随机ASCII公司邮箱名 |
| ascii_email() | 随机ASCII邮箱 |
| ascii_free_email() | |
| ascii_safe_email() | |
| company_email() | |
| domain_name() | 生成域名 |
| domain_word() | 域词(即,不包含后缀) |
| email() | |
| free_email() | |
| free_email_domain() | |
| f.safe_email() | 安全邮箱 |
| f.image_url() | 随机URL地址 |
| ipv4() | 随机IP4地址 |
| ipv6() | 随机IP6地址 |
| mac_address() | 随机MAC地址 |
| tld() | 网址域名后缀(.com,.net.cn,等等,不包括.) |
| uri() | 随机URI地址 |
| uri_extension() | 网址文件后缀 |
| uri_page() | 网址文件(不包含后缀) |
| uri_path() | 网址文件路径(不包含文件名) |
| url() | 随机URL地址 |
| user_name() | 随机用户名 |
| isbn10() | 随机ISBN(10位) |
| isbn13() | 随机ISBN(13位) |
| job() | 随机职位 |
| paragraph() | 随机生成一个段落 |
| paragraphs() | 随机生成多个段落,通过参数nb来控制段落数,返回数组 |
| sentence() | 随机生成一句话 |
| sentences() | 随机生成多句话,与段落类似 |
| text() | 随机生成一篇文章(不要幻想着人工智能了,至今没完全看懂一句话是什么意思) |
| word() | 随机生成词语 |
| words() | 随机生成多个词语,用法与段落,句子,类似 |
| binary() | 随机生成二进制编码 |
| boolean() | True/False |
| language_code() | 随机生成两位语言编码 |
| locale() | 随机生成语言/国际 信息 |
| md5() | 随机生成MD5 |
| null_boolean() | NULL/True/False |
| password() | 随机生成密码,可选参数:length:密码长度;special_chars:是否能使用特殊字符;digits:是否包含数字;upper_case:是否包含大写字母;lower_case:是否包含小写字母 |
| sha1() | 随机SHA1 |
| sha256() | 随机SHA256 |
| uuid4() | 随机UUID |
| first_name() | |
| first_name_female() | 女性名 |
| first_name_male() | 男性名 |
| first_romanized_name() | 罗马名 |
| last_name() | |
| last_name_female() | 女姓 |
| last_name_male() | 男姓 |
| last_romanized_name() | |
| name() | 随机生成全名 |
| name_female() | 男性全名 |
| name_male() | 女性全名 |
| romanized_name() | 罗马名 |
| msisdn() | 移动台国际用户识别码,即移动用户的ISDN号码 |
| phone_number() | 随机生成手机号 |
| phonenumber_prefix() | 随机生成手机号段 |
| profile() | 随机生成档案信息 |
| simple_profile() | 随机生成简单档案信息 |
| 参数 | 说明 |
|---|---|
| pybool() | 布尔类型 |
| pydecimal() | 数字 |
| pydict() | 字典 |
| pyfloat() | left_digits=5 #生成的整数位数, right_digits=2 #生成的小数位数, positive=True #是否只有正数 |
| pyint() | 整型 |
| pyiterable() | 迭代器 |
| pylist() | 列表 |
| pyset() | 集合 |
| pystr() | 字符串 |
| pystruct() | 结构体 |
| pytuple() | 元组 |
| 参数 | 说明 |
|---|---|
| ssn() | 生成身份证号 |
| chrome() | 随机生成Chrome的浏览器user_agent信息 |
| firefox() | 随机生成FireFox的浏览器user_agent信息 |
| internet_explorer() | 随机生成IE的浏览器user_agent信息 |
| opera() | 随机生成Opera的浏览器user_agent信息 |
| safari() | 随机生成Safari的浏览器user_agent信息 |
| linux_platform_token() | 随机Linux信息 |
| user_agent() | 随机user_agent信息 |
记录下python生成统计图的一些常规使用,主要是2D的统计图,3D的暂不涉及
|
|
|
|
| 中文字体名 | 英文字体名 |
|---|---|
| 宋体 | SimSun |
| 黑体 | SimHei |
| 微软雅黑 | Microsoft YaHei |
| 微软正黑体 | Microsoft JhengHei |
| 新宋体 | NSimSun |
| 新细明体 | PMingLiU |
| 细明体 | MingLiU |
| 标楷体 | DFKai-SB |
| 仿宋 | FangSong |
| 楷体 | KaiTi |
| 隶书 | LiSu |
| 幼圆 | YouYuan |
| 华文细黑 | STXihei |
| 华文楷体 | STKaiti |
| 华文宋体 | STSong |
| 华文中宋 | STZhongsong |
| 华文仿宋 | STFangsong |
| 方正舒体 | FZShuTi |
| 方正姚体 | FZYaoti |
| 华文彩云 | STCaiyun |
| 华文琥珀 | STHupo |
| 华文隶书 | STLiti |
| 华文行楷 | STXingkai |
| 华文新魏 | STXinwei |
|
|
这里的字体样式基本跟CSS的font一样
具体可以参考CSS的font说明: https://www.w3school.com.cn/cssref/pr_font_font.asp
应朋友要求,研究下deepfacelab的环境搭建和使用步骤,记录下中间的问题和过程。
|
|
win10环境,软件磁力连接(迅雷复制下载):
|
|
1、如果用的步骤3中的成熟项目包只需要依赖python3
2、如果用的步骤2中的核心库自行搭建的话,需要安装如下清单
最近看到一篇关于汉字点选登录校验的学习模型,觉得比较有趣,可以搜集,成功率很高,93%以上的成功率,还是很不错的,于是下载并搭建环境,但是安装其中kenlm语言模型模块时走了不少弯路,记录下
该工程需要依赖如下module,除了最后一个不好安装外,其他都比较容易,tensor修改下源或者网络好下载也快
……BackgroundRemover是一个命令行工具,用于从视频 和图像中删除背景
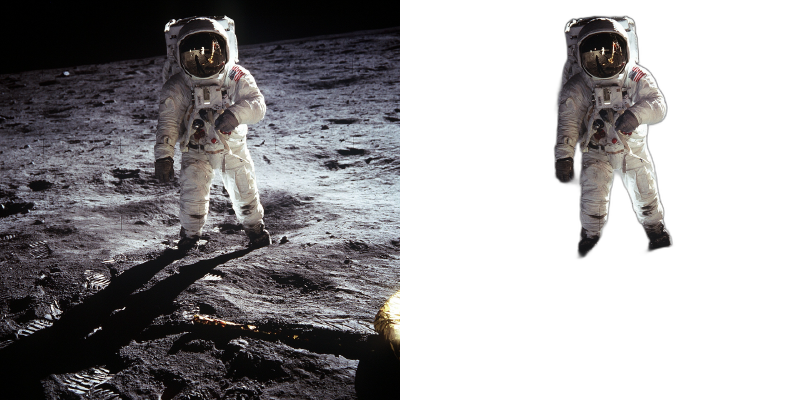
Requirements
python <= 3.6
python3.6-dev #or what ever version of python you using
torch and torchvision stable version https://pytorch.org
ffmpeg 4.4+
|
|
|
|
如果不提前下载模型的话,在首次执行的时候会自动下载,但是需要从 google 网盘下载,因此需要有翻墙能力。
如果手工下载可以参考下面地址:
1、https://github.com/xuebinqin/U-2-Net#usage-for-salient-object-detection,参考章节"Download the u2net_portrait.pth"
2、https://pan.baidu.com/s/1FbUIBJsEua7G1vYo06lSmg 提取码: o0uu
3、https://drive.google.com/u/0/uc?id=1rbSTGKAE-MTxBYHd-51l2hMOQPT_7EPy&export=download
测试web系统的sql注入问题,学着使用神器sqlmap,下载了最新版本。
Git地址:https://github.com/sqlmapproject/sqlmap
前提条件设置好python2.7和环境变量,python3.6也支持只是2.7当前工具更多
以某自己搭建的注入点为例:记录下加搜集的参数含义
格式:http(s)://targeturl[:port]/[…]
例如:Python sqlmap.py -u “http://www.target.com/vuln.PHP?id=1" -f –banner –dbs –users