IndexTTS-1.5本地搭建试用:B站开源的零样本语音克隆TTS
前言
最近一直在折腾 AI 工具链(agent、skill、MCP 这些),就琢磨着让 AI 的产出再进一步——比如给视频配音、给播报类内容配上音色。市面上的 TTS 云服务要么按字符收费、要么音色固定,B 站开源的 IndexTTS 支持零样本音色克隆:给十几秒的参考音频,就能模仿着这个音色把任意文本读出来,模型权重直接开放下载,本地就能跑,正合适。
于是下载了 IndexTTS-1.5 到本地完整搭了一遍,记录 Mac 上从零到出声的过程中的爬坑经验。
项目地址:https://github.com/index-tts/index-tts
1、IndexTTS 是个啥
先花一分钟说清楚它是什么,后面搭建时每个步骤为什么这么走就都顺理成章了:
- 零样本语音克隆:不用训练、不用微调,上传一段参考音频(说几句话就行),模型提取音色特征后用这个声音读任意文本
- GPT 风格的架构:基于 XTTS、Tortoise 的思路改进,接了 BigVGAN2 声码器提升音质,数万小时数据训练
- 中文友好:支持用拼音纠正多音字的发音,标点符号可以控制停顿位置——这两点对中文内容创作很实用
- 1.5 版是稳定增强版:2025 年 5 月发布,中文错误率(WER 0.821)和英文表现在开源 TTS 里都是第一梯队
模型在 HuggingFace 和 ModelScope 都有,整体是「源码 + 权重」两块:源码负责推理,权重约 2.9G 放 checkpoints/ 目录。
2、搭建过程
我的环境:Intel MacBook Pro(i7 + AMD 显卡,没有 N 卡没有 CUDA),conda 建基础环境、依赖安装走 uv,安装目录 ~/Downloads/Code/AI/index-tts-1.5.0。先给结论:整套能搭通、能出声,就是推理速度偏慢——没有 CUDA 的机器这是硬伤,后面细说。
2.1 环境准备:conda + ffmpeg
先下载源码(也可以直接下 release 包解压,效果一样),然后建独立环境,Python 固定 3.10:
|
|
这里 conda 只干两件事:提供 Python 3.10 的解释器、装 ffmpeg 这类系统级依赖;pip 侧的依赖全部交给下一节的 uv 处理。
ffmpeg 是处理音频依赖的(重采样、格式转换),没装的话先装一个:
|
|
我机器上已经有 MacPorts 装的 4.4.6,直接复用,不再折腾。
2.2 安装依赖:uv 方案
装依赖这步我没用裸 pip,用的是 uv——Rust 写的包管理器(ruff 同门),依赖解析和下载都是并行化过的,torch 全家桶加 transformers 这一大串依赖,pip 要转半天,uv 基本一口气装完,还有全局缓存,换环境重装直接命中缓存。用法和 pip 平移兼容,没有心智负担:
|
|
和 README 的 pip install -e ".[webui]" 逐个对应:-e 可编辑安装(改源码即时生效);带 [webui] 这个 extra 才会把 gradio 装上(setup.py 里 webui extra 就是 gradio),否则 webui 起不来;--no-build-isolation 必须保留,setup.py 构建时要 import 已装好的 torch,默认的隔离构建会报 torch 找不到。
装完核心依赖长这样(uv pip list 核对):
|
|
顺带一提:仓库里有个 uv.lock,打开只有 3 行元数据——这项目的依赖全写在 requirements.txt,pyproject 里没声明,uv 根本锁不出东西,别指望靠这个文件复现环境。
2.3 Intel Mac 的 torch 停更坑
这是 Intel Mac 搭 AI 环境绕不开的一坑:PyTorch 从 2.3 起不再给 macOS 出 x86_64 的包,2.2.2 就是 Intel Mac 能装到的最后一个版本。pip index versions torch 一查便见分晓:
|
|
往新走 macOS 只剩 arm64(Apple Silicon)的包。这意味着:
- torch 装到 2.2.2 就封顶了,pip、uv 都一样,这是停更不是选择
- 整个依赖树要跟着这个 2024 年初的老版本保守搭配:项目 requirements.txt 本来就把 transformers 钉在 4.36.2,和 torch 2.2.2 是配套的老组合,别手痒升级全家桶,各种 API 兼容问题能排到你怀疑人生
- README 里的 torch 安装命令带
--index-url .../cu118是给 N 卡用户的,Mac 上不要照抄,装默认版就行
Apple Silicon(M 系列)的 Mac 没有这个坑,直接装新版 torch。另外 README 提到 Windows 装 pynini 会编译失败要走 conda,Mac 上没这个问题。
2.4 下载模型权重:HuggingFace CLI 拉取约 2.9G
权重托管在 HuggingFace 的 IndexTeam/IndexTTS-1.5 仓库,7 个文件一次拉齐。CLI 不用单独装——前面装依赖时 huggingface_hub 已经带上了,新版命令叫 hf,README 里写的 huggingface-cli 是老名字,两个等价都能用。国内先把镜像切了再下:
|
|
几个点说清楚:
- 不用登录 token:公开模型匿名就能拉,不需要先
hf auth login - 断点续传是内置的:下载中的分块临时文件放在
checkpoints/.cache/huggingface/download/下,每个文件配一组.lock锁和.metadata元数据,下完才落到--local-dir根目录,.cache里只剩 32K 的元数据。中途断了重跑同一条命令,会自动从断点接着下,不会 2.9G 从头来 - 命令里那串文件名就是白名单:不写文件名默认拉整仓,写了就只下这几个——但也正因此容易漏,
bpe.model、unigram_12000.vocab这两个几百 K 的小文件千万别漏,启动加载时缺哪个报哪个的错,跟网络无关,纯粹是下载清单没对齐 - CLI 不想用的,README 还给了 wget 逐个文件拉的笨办法(域名同样可以换成 hf-mirror.com),国内 ModelScope 也有同名仓库可下
下完核对 checkpoints/ 目录,四个大件加起来约 2.9G:
|
|
.cache/ 目录确认跑通之后删掉也不影响加载。
3、启动 webui
权重就位后一条命令起服务:
|
|
首次启动要把几个模型逐一加载进内存,耐心等它刷完日志。这是我机器上的完整启动输出:
|
|
逐行对一下心里有底:
GPT weights restored/bigvgan weights restored:主模型和声码器权重加载成功,中间那句Removing weight norm...是 BigVGAN 初始化的正常输出,不是报错TextNormalizer loaded/bpe model loaded:文本正则器和 BPE 分词模型就位- 注意 bpe 那行的路径是
checkpoints/checkpoints/bpe.model,嵌套了一层——这不是下载错了,是 1.5.0 自己的路径拼接问题,也是踩坑记录第 1 条的由来,首启能不能过就看它 - 看到
Running on local URL就绪了;最后一句share=True是 gradio 的公网链接提示,本地用不用管
浏览器打开 http://127.0.0.1:7860,能看到界面就说明 webui 这条链路通了:左边传参考音频,右边输文本,还能选 ordinary / fast 两种推理模式(fast 是分句批量推理,长文本快不少)。
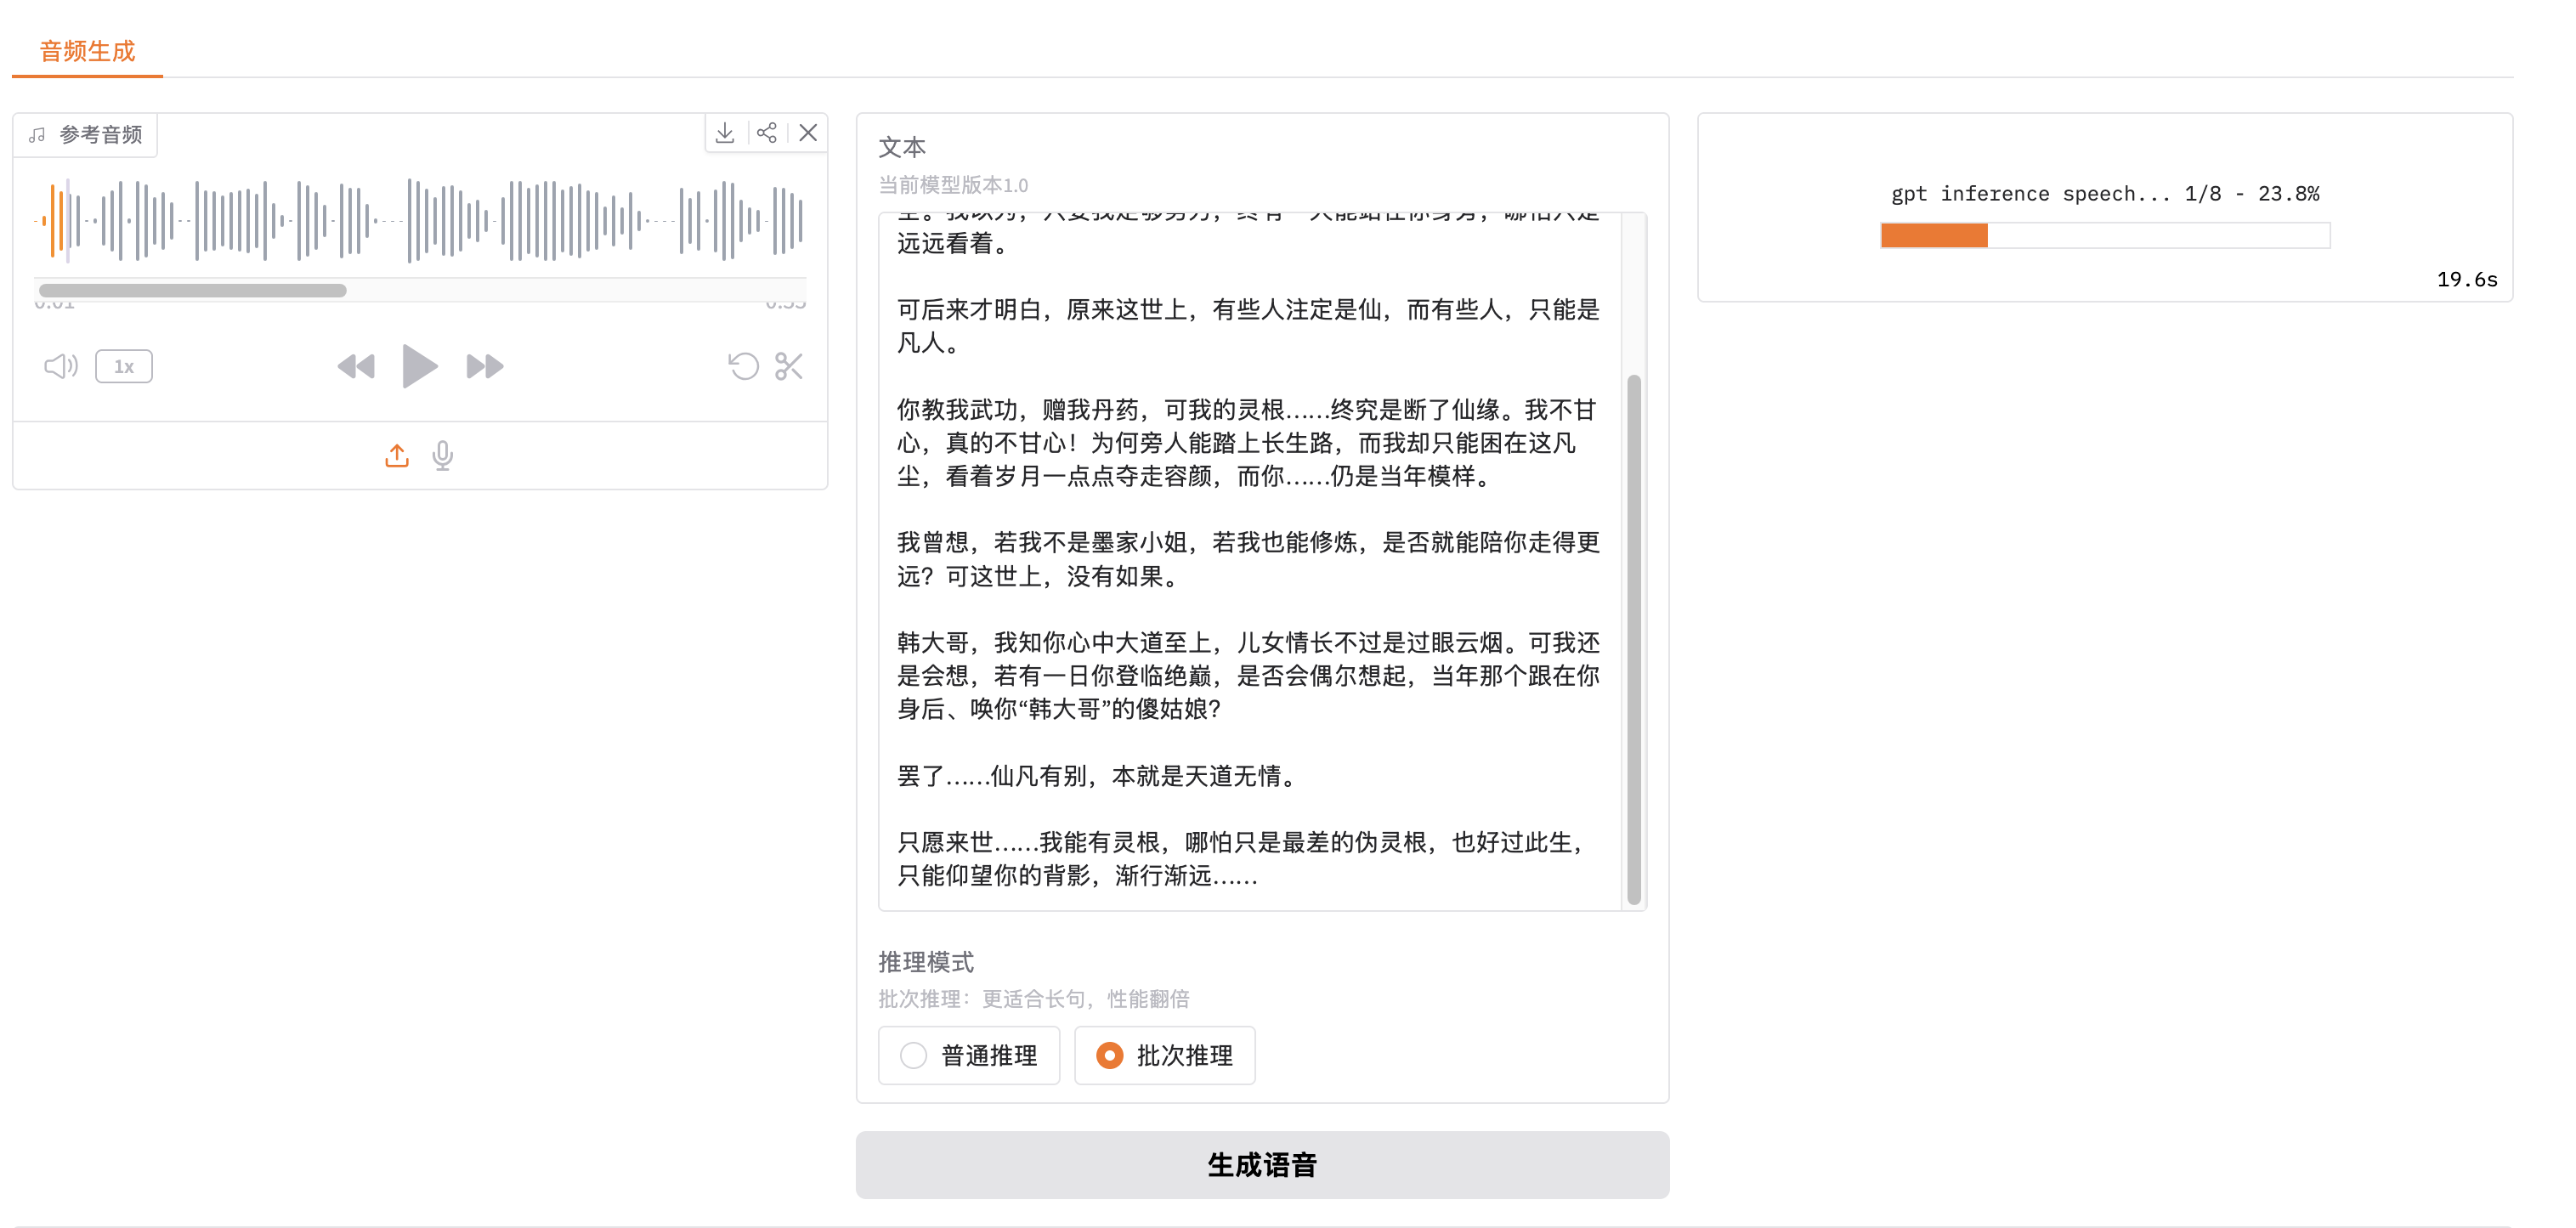
界面就是上图:左边传参考音频,右边合成文本(文本框里那段「正在bilibili体验ai科技」是项目自带的示例文本),下方推理模式二选一——对应前文说的 ordinary(常规推理)/ fast(极速推理),温度、top_p、top_k 这几个采样参数也在这儿调,点「一键合成!」等结果就行。
4、试用:证明搭建成功
搭好没搭好,出声才算数。试用就干三件事:传参考音频、合成、验证产物。
4.1 webui 界面合成
找了一段干净的人声录音(十几秒、无背景音),在界面里上传作为参考音频,输入一段中文文本点生成。第一次跑得再等一会儿——一段 25 秒左右的音频要等几分钟,没有 CUDA 的 N 卡,速度就是上不去。
设备这块当时没多想:推理代码(indextts/infer.py)的设备是自动检测的——有 CUDA 用 CUDA,检测到 MPS 用 MPS,都没有才退 CPU。2 月份搭建时系统还是 macOS 10.15(Catalina),MPS 框架压根不存在,设备自动落在 cpu,就靠 cpu 硬跑,5 段 wav 全部出声。后来升级系统又踩出 MPS 的连环雷,那段故事在踩坑记录第 6 条。
生成成功的标志:界面能直接播放,同时项目目录的 outputs/ 下落了产物文件:
|
|
换不同风格的参考音频又合成了几段,outputs/ 里攒了 5 个 wav——音色都跟着参考音频走,字音、断句正常,多音字没有翻车。到这一步,零样本克隆的完整链路(参考音频 → 音色提取 → 合成)已经全部验证通过。
4.2 产物验证:别光靠耳朵
试听之外用 afinfo 看下文件规格,确认生成的是正经音频而不是空壳:
|
|
|
|
24kHz 单声道、25.6 秒,规格正常。webui 的输出文件名规则是 spk_{时间戳}.wav(webui.py 里写死的 spk_{int(time.time())}.wav),多合成几次按时间排一下就能对上每段是哪次生成的。
4.3 修复后的实测:cpu 性能数据与试听
踩坑第 6 条修复(device="cpu")之后,又跑了一次完整的 fast 推理做验证——用 55 秒的台词录音做参考音频,合成 91 秒长文本,这次日志把性能数据全打出来了:
|
|
几个数字读一下,cpu 的性能画像就很具体了:
- RTF 12.52:Real-Time Factor,生成 1 秒音频要花 12.5 秒——91 秒的音频等了 19 分钟(1139 秒),和总耗时正好对上。前面说「25 秒音频等几分钟」,按这个 RTF 算就是 5 分钟出头,数据自洽
- 大头在 gpt_gen_time(901 秒,占 79%):GPT 自回归逐 token 生成语音码本,天生串行,cpu 上就是慢;bigvgan 声码器反而只要 178 秒(8 批 3 分钟,进度条一格格走完还挺解压)
- fast 模式把长文本切成 8 批(batch_num: 8)分批推理,这是它比 ordinary 快的原因,但 cpu 底子在这,快也只是相对的
生成结果界面长这样,参考音频(55.3 秒的 webm 直接丢进去,webui 自己处理重采样和声道转换)和生成的音频(90.97 秒)都在:
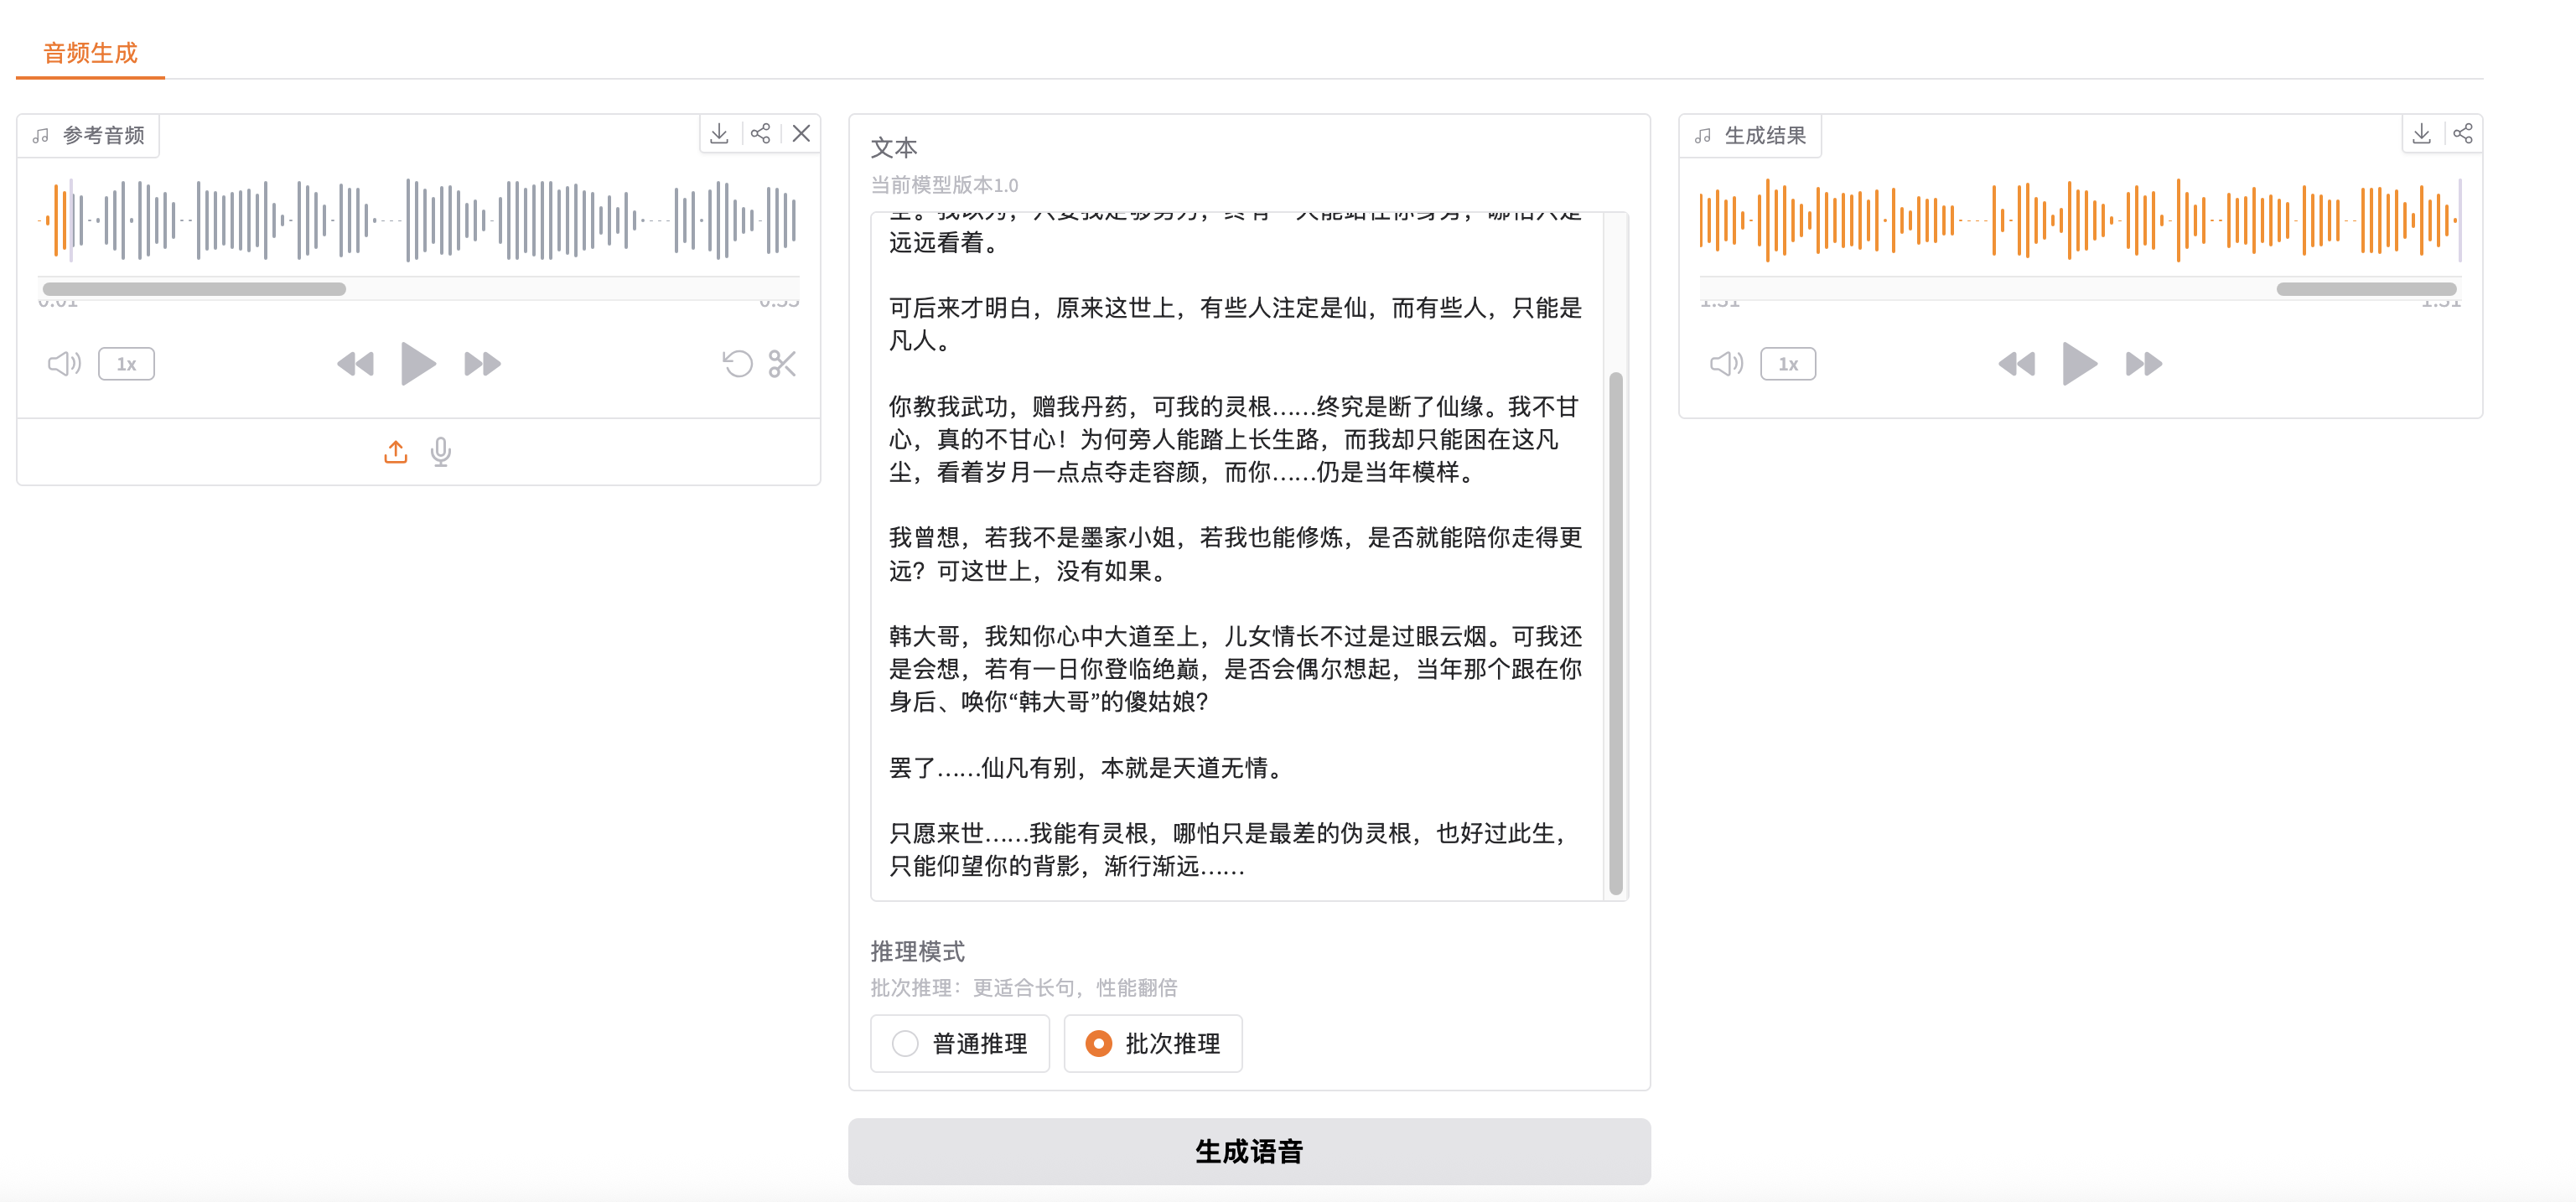
实际效果可以直接试听——克隆墨彩环音色合成的这段:
就是日志里那个 spk_1792747708.wav 原文件,24kHz 单声道,浏览器直接点播放。
4.4 命令行方式(可选)
不想开浏览器的话,pip install -e . 时注册的 CLI 也能合成,一条命令出文件:
|
|
和 webui 是同一个内核,webui 验证过了这里必然通,写出来是给以后写脚本批量合成用的。
5、踩坑记录
-
bpe.model 的加载路径双层嵌套:首启报找不到 bpe.model,一开始还以为是下载漏了文件,看启动日志才发现它要加载的是
checkpoints/checkpoints/bpe.model——七个文件里只有它一个走嵌套路径。翻了代码才明白:config.yaml 里写的是bpe_model: checkpoints/bpe.model(相对项目根),infer.py又拿这个值跟model_dir再拼一次(os.path.join(model_dir, ...)),双层 checkpoints 就这么来的。解决二选一:建checkpoints/checkpoints/目录把 bpe.model 放进去(我用的这个),或者把 config.yaml 那行改成bpe_model: bpe.model -
Intel Mac torch 停更:PyTorch 2.2.2 之后 macOS 只出 arm64 的包,x86_64 封顶装到 2.2.2,升无可升;依赖树要跟着这个版本保守搭配(transformers 4.36.2 这套),别盲目升全家桶,详见 2.3 节
-
小文件漏下必报错:
bpe.model、unigram_12000.vocab才几百 K,最容易被漏,启动加载时报错的文件名就是缺的那个,对着补 -
没有 CUDA 的 GPU 就慢:这台 Intel Mac 没有 CUDA,BigVGAN 的融合 kernel 用不了,一段 25 秒的音频在 cpu 上要等几分钟(macOS 15 之后 AMD 显卡能借 MPS 出点力,但会踩出第 6 条的新坑)——跑通验证够用,批量生产上 N 卡
-
参考音频质量直接决定克隆效果:背景音杂、时长太短的参考音频,合成出来的音色会飘,选十几秒以上干净人声,效果立竿见影
-
升级 macOS 后推理报
unsupported autocast device_type 'mps':最隐蔽的一坑,大半年后才爆出来。2 月份系统还是 macOS 10.15(Catalina),没有 MPS 框架,torch.backends.mps.is_available()返回 False,设备自动走 cpu,ordinary、fast 都跑得欢。后来系统升到 macOS 15.7.4(Sequoia),MPS 框架有了,is_available()变 True,设备自动切成 mps——而且不是虚报,torch 2.2.2 的 MPS 后端在这台 Intel 机器上真能算,AMD 显卡走 Metal,实测 matmul 比 CPU 快一个数量级,fp16、conv1d 都通。坏就坏在torch.amp.autocast的设备白名单 2.2.2 里没有 mps(autocast 的 mps 支持要 2.3 才加),infer.py里 5 处torch.amp.autocast(xxx.device.type, ...)动态传参全部撞雷,fast(3 处)、ordinary(2 处),点生成就炸。报错栈(中间 gradio/anyio 的框架帧省了)最后落在这行:1 2 3 4 5 6 7 8 9 10>> start fast inference... Traceback (most recent call last): ......(gradio/anyio 框架栈帧,省略)...... File "/Users/tuchenguang/Downloads/Code/AI/index-tts-1.5.0/webui.py", line 88, in gen_single output = tts.infer_fast(prompt, text, output_path, verbose=cmd_args.verbose, File "/Users/tuchenguang/Downloads/Code/AI/index-tts-1.5.0/indextts/infer.py", line 384, in infer_fast with torch.amp.autocast(batch_text_tokens.device.type, enabled=self.dtype is not None, dtype=self.dtype): File "/opt/miniconda3/envs/index-tts-1.5/lib/python3.10/site-packages/torch/amp/autocast_mode.py", line 241, in __init__ raise RuntimeError( RuntimeError: User specified an unsupported autocast device_type 'mps'栈里两个业务帧就是证据:
webui.py:88调的是infer_fast(fast 模式),infer.py:384正是那行动态传参的 autocast,device_type 传进去的是 ‘mps’——推理确实跑在 mps 上,被 2.2.2 的白名单拦下。所以不是升级弄坏了环境,是升级让设备从 cpu 切到了 mps,撞上 torch 停更版的坑——第 2 条换了个姿势又来了一次,想升 torch 绕过?Intel Mac 装不了,闭环了。恢复二选一:最省事是webui.py的IndexTTS(...)构造里加device="cpu"钉死,构造函数会自动关掉 fp16,autocast 的 enabled 跟着变 False,一行回到升级前的等效状态;想吃 MPS 加速就在webui.py顶部 monkeypatch autocast,mps 时映射成 cpu 并关掉 amp:1 2 3 4 5 6 7import torch _orig_autocast = torch.amp.autocast def _mps_safe_autocast(device_type, enabled=True, **kwargs): if device_type == "mps": # torch 2.2 的 autocast 不认 mps,2.3 才支持 device_type, enabled = "cpu", False return _orig_autocast(device_type, enabled=enabled, **kwargs) torch.amp.autocast = _mps_safe_autocast
总结
整个搭建下来体会:IndexTTS-1.5 的部署门槛不高,坑都在「环境对不对、版本对不对、文件全不全」这种细节上——conda 建基础环境、uv 装依赖、镜像拉权重、python webui.py 起服务,一气呵成;Intel Mac 上 torch 停更 2.2.2 封顶是第一个要认命的坑,这个坑后来还连着升级 macOS 后的 autocast ‘mps’ 雷,好在钉回 device="cpu" 一行就恢复,就是没有 CUDA 整体速度慢,试用验证完全够用。零样本克隆的效果对得起开源第一梯队的评价,后续想批量合成(比如给文章自动配音频、给视频配音)就在 CLI 基础上包个脚本,遇到类似的本地 TTS 部署需求可以直接参考这篇。
相关阅读
- 原文作者:Anttu
- 原文链接:https://anTtutu.github.io/post/2026-02-10-index-tts-1-5/
- 版权声明:本作品采用知识共享署名-非商业性使用-禁止演绎 4.0 国际许可协议进行许可,非商业转载请注明出处(作者,原文链接),商业转载请联系作者获得授权。