前言

主从复制是 mysql 高可用的基础:读写分离、故障切换、异地备份都建立在它之上。这篇整理主从搭建的完整步骤、状态检查要点,以及复制中断后的几种恢复手段——生产环境主从挂掉大多是「中断后不知道怎么安全地恢复」,这部分才是重点。

一、主库(Master)配置

1. 修改 my.cnf 开启 binlog

1
2
3
[mysqld]
log-bin    = mysql-bin
server-id  = 1

2. 重启后创建复制账号

1
2
GRANT REPLICATION SLAVE, REPLICATION CLIENT ON *.* 
  TO 'repl'@'192.168.1.20' IDENTIFIED BY 'your_password';

3. 查看主库状态(记下 File 和 Position,从库对接要用)

1
SHOW MASTER STATUS\G

二、从库(Slave)配置

1. 修改 my.cnf

1
2
3
4
5
6
[mysqld]
relay_log         = mysql-relay-bin
log_slave_updates = 1
read_only         = 1
replicate-do-db   = your_db
server-id         = 2

注意:多台从库的 server-id 绝不能重复——克隆机器搭建的从库最容易踩这个坑。

2. 重启后建立复制关联

1
2
3
4
5
6
CHANGE MASTER TO 
  MASTER_HOST='192.168.1.10', 
  MASTER_USER='repl', 
  MASTER_PASSWORD='your_password', 
  MASTER_LOG_FILE='mysql-bin.000007', 
  MASTER_LOG_POS=154;

MASTER_LOG_FILE / MASTER_LOG_POS 要对应主库 SHOW MASTER STATUS 查出来的值。

3. 启动并检查复制线程

1
2
3
START SLAVE;
SHOW SLAVE STATUS\G;
STOP SLAVE;   -- 停止复制

三、server_uuid 冲突报错

如果错误日志出现:

1
2
Got fatal error 1236 from master when reading data from binary log: 
'A slave with the same server_uuid/server_id as this slave has connected to the master'

原因是复制过来的数据目录里 auto.cnf 中生成的 UUID 与其他实例撞了。直接删掉 data 目录下的 auto.cnf 重启,让 mysql 重新生成 UUID 即可。

四、状态检查看什么

SHOW SLAVE STATUS\G 输出很长,重点盯这几行:

Slave_IO_State 状态

IO 线程状态为 Waiting for master to send event 说明与主库的连接正常。
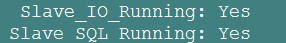
双 Yes 检查

Slave_IO_Running 和 Slave_SQL_Running 必须同时为 Yes——前者负责拉主库 binlog,后者负责回放 relay log,任何一个为 No 复制就断了。
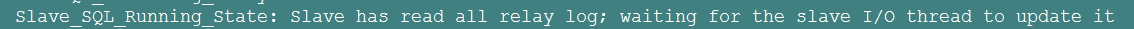
SQL 线程状态

Slave has read all relay log; waiting for the slave I/O thread to update it 表示 SQL 线程已追平,处于正常等待。

五、复制中断的三种恢复策略

从库回放出错(常见如主从表结构不一致、记录不存在)时,Last_Errno / Last_Error 会给出原因:

复制报错示例

上例是错误码 1677:主从同一列的 varchar 长度不一致导致转换失败。处理按优先级:

方法 1:跳过错误 Event(错误量少时首选)

1
2
3
STOP SLAVE;
SET GLOBAL sql_slave_skip_counter = 1;
START SLAVE;

一条条跳,跳完观察是否恢复正常。

方法 2:跳过指定类型的错误

在 my.cnf 的复制配置段加:

1
slave-skip-errors = 1032

重启实例后 START SLAVE。因为要重启数据库不推荐,除非错误事件太多逐条跳不现实。

方法 3:还原被误删的数据

根据报错指向的 binlog 位置,用 mysqlbinlog 找出该条 event 的 SQL 手动逆向执行(如 delete 改 insert):

1
2
3
4
5
6
7
8
9
mysqlbinlog --base64-output=decode-rows -vv mysql-bin.000003 | grep -A 20 '440267874'

# 或按停止位置截取尾部
mysqlbinlog --base64-output=decode-rows -vv mysql-bin.000003 \
  --stop-position=440267874 | tail -20

# 加 -d your_db 可按库进一步过滤
mysqlbinlog --base64-output=decode-rows -vv mysql-bin.000114 \
  --database=your_db --stop-position=944505815 > decode.log

跳错命令(SET GLOBAL SQL_SLAVE_SKIP_COUNTER)慎用:跳多了主从表面正常、数据实际不一致,排查起来更痛苦。

六、修复表结构不一致

报错 1677 这类问题,根因是主从表结构 drift。确认两边建表语句:

1
SHOW CREATE TABLE your_db.your_table;

不一致时以主库为准修正从库;顺手统一字符集:

1
ALTER TABLE your_db.your_table CONVERT TO CHARACTER SET utf8;

七、用 mydumper 快速重建备库

错误积累太多、或想从指定时间节点重搭从库时,物理备份重建比逐条修复快得多:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
# 备份(记下备份时刻主库的 Log/Pos)
mydumper -u root -p your_password -h localhost -B your_db -o /data/db_backup/20200417

# 恢复(-t 指定并发线程数)
myloader -u root -p your_password -h localhost -B your_db -t 20 -d /data/db_backup/20200417

# 按备份时记录的 Log/Pos 重新对接主库
CHANGE MASTER TO MASTER_HOST='192.168.1.10', MASTER_USER='repl',
  MASTER_PASSWORD='your_password', 
  MASTER_LOG_FILE='binlog.000227', MASTER_LOG_POS=15027527;

八、主从一致性校验

修复或跳错之后,用两份SQL校验数据是否还对得上:

1
2
3
4
5
6
7
8
-- 表数量是否一致
SELECT COUNT(*) TABLES, table_schema 
FROM information_schema.TABLES GROUP BY table_schema;

-- 各表行数是否一致(估算值,大表有偏差但足够发现量级差异)
SELECT table_name, table_rows 
FROM information_schema.TABLES 
WHERE TABLE_SCHEMA = 'your_db' ORDER BY table_rows DESC;

总结

主从复制三个关键点:搭建时 server-id 唯一(克隆机器记得删 auto.cnf);巡检时盯住 两个 Running 都为 Yes;中断后优先「定位报错 → 少量跳过 / 逆向修复 → 一致性校验」,跳错是最后手段。数据量大时直接 mydumper 重建从库,比反复跳错可靠得多。

参考


相关阅读